
文档 /
教程 /
Depth Anything 3:ComfyUI 深度估计、相机位姿与 3D 重建
Depth Anything 3:ComfyUI 深度估计、相机位姿与 3D 重建
在 ComfyUI 中使用 Depth Anything 3 进行单目和多视角深度估计、相机位姿恢复,以及基于图像和视频的 3D 重建。
教程
depth-anything-3 更新于 2026-11-12
Depth Anything 3:ComfyUI 深度估计、相机位姿与 3D 重建
在 ComfyUI 中使用 Depth Anything 3 进行单目和多视角深度估计、相机位姿恢复,以及基于图像和视频的 3D 重建。
ComfyUI Depth Anything 3 简介
Depth Anything 3 (DA3) 来自字节跳动豆包团队,是一个视觉 Transformer,能够从任意视觉输入中恢复空间一致的几何信息,无论是否具有已知的相机位姿。单个 DINO 编码器和统一的深度-射线表示使得同一模型家族能够覆盖单目深度、多视角深度、相机位姿估计和 3D 重建。
主要能力:
- 统一单目与多视角深度:从单张图像或多张图像估计深度
- 相机位姿估计:从无序图像集合中恢复相机位置
- 3D 重建:支持多视角输入
- 视频深度估计:为视频输入生成逐帧深度序列
- 多种模型变体:Small、Base、Mono/Metric Large
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。
[!TIP] ComfyUI 现已原生支持 Depth Anything 3 节点。开始前请确保已更新到最新版本的 ComfyUI。
模型下载
下载 Depth Anything 3 的模型文件并将其保存到对应的 ComfyUI 文件夹:
- Small (depth\_anything\_3\_small.safetensors) — 轻量快速推理
- Base (depth\_anything\_3\_base.safetensors) — 平衡性能
- Mono-Large (depth\_anything\_3\_mono\_large.safetensors) — 最佳单目深度,含天空检测
- Metric-Large (depth\_anything\_3\_metric\_large.safetensors) — 物理度量深度(米级)
ComfyUI/
├── models/
│   ├── geometry_estimation/
│   │   ├── depth_anything_3_small.safetensors
│   │   ├── depth_anything_3_base.safetensors
│   │   ├── depth_anything_3_mono_large.safetensors
│   │   └── depth_anything_3_metric_large.safetensors
示例工作流
Depth Anything 3:图像深度估计
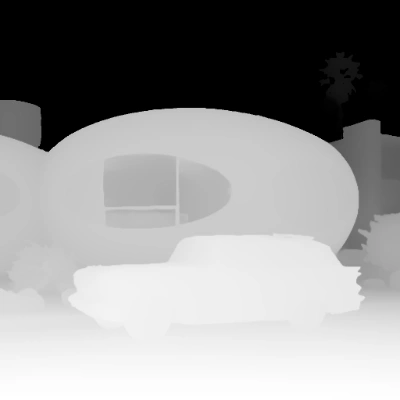
上传一张图像,使用 Depth Anything 3 生成深度图。并排查看原始图像与深度输出的对比。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“Depth Anything 3:图像深度估计”
输入素材
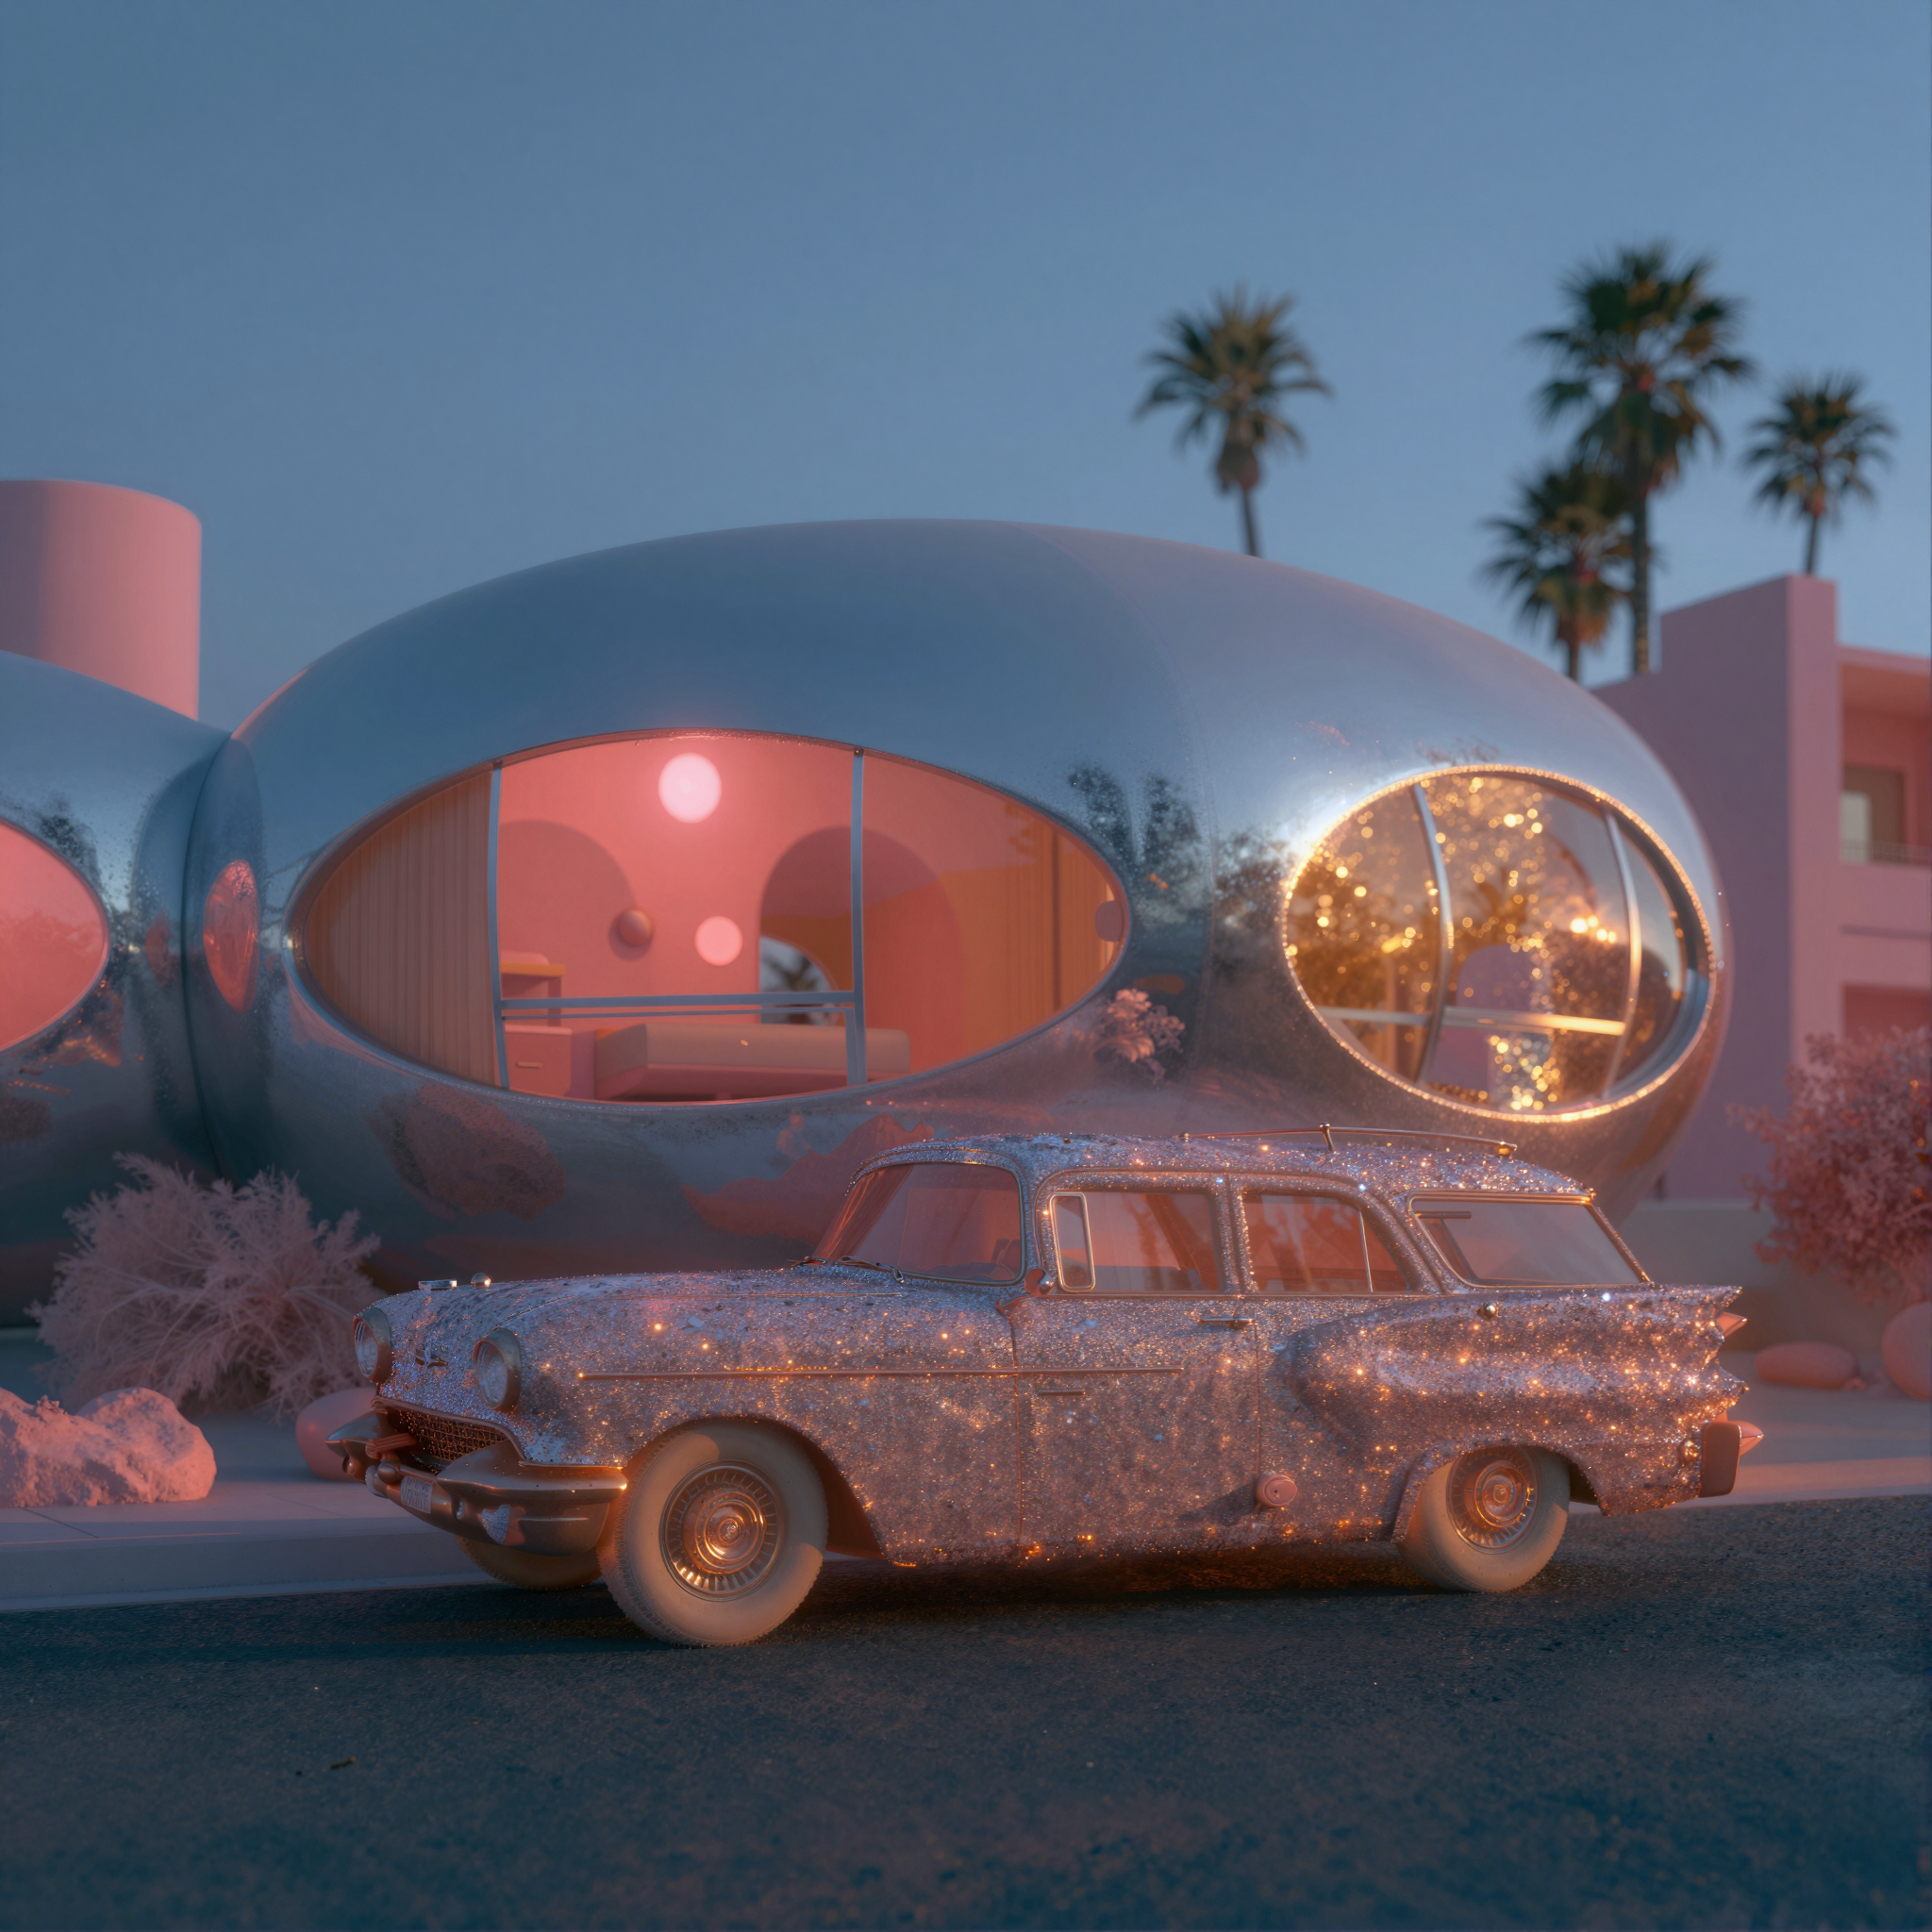
将此文件上传到对应的 LoadImage 节点:
[card] retro\_futuristic\_home.pngLoadImage节点 85 ·retro_futuristic_home.png
运行步骤
- LoadImage:加载输入图像
- LoadDA3Model:选择 Depth Anything 3 变体
- Run:点击 Queue 或使用
Cmd+Enter - 工作流将输出深度图和并排对比图
[card] 了解 Subgraph 此工作流使用 Subgraph 节点进行模块化处理。查看 Subgraph 文档,了解如何自定义和扩展工作流。
Depth Anything 3:视频深度估计
上传视频,逐帧生成深度序列。在 Subgraph 内部,GetVideoComponents 将输入视频拆分为帧,LoadDA3Model 加载模型,SetVideoComponents 将深度帧重新组合为视频输出。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“Depth Anything 3:视频深度估计”
输入素材
将此文件上传到对应的 LoadVideo 节点:
[card] empty\_room\_assembly.mp4LoadVideo节点 87 ·empty_room_assembly.mp4
<video controls> <source src="https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/empty_room_assembly.mp4" type="video/mp4" /> </video>
运行步骤
- LoadVideo:加载输入视频
- Select Model:在 Small、Base、Mono-Large 或 Metric-Large 之间选择
- Run:点击 Queue 或使用
Cmd+Enter - 工作流将输出包含逐帧深度图的视频
[card] 了解 Subgraph 此工作流使用 Subgraph 节点进行模块化处理。查看 Subgraph 文档,了解如何自定义和扩展工作流。
模型变体
| 变体 | head\_type | 天空检测 | 置信度 | 相机解码 | 最佳用途 |
|---|---|---|---|---|---|
| Small | dualdpt | ❌ | ✅ | ✅ | 快速推理、移动/边缘设备 |
| Base | dualdpt | ❌ | ✅ | ✅ | 均衡性能 |
| Mono-Large | dpt | ✅ | ❌ | ❌ | 带天空检测的单目深度 |
| Metric-Large | dpt | ✅ | ❌ | ❌ | 物理度量深度(米级输出) |
- Small 和 Base 使用
dualdpt头类型,支持置信度估计和相机解码器,适用于多视角应用。 - Mono-Large 和 Metric-Large 使用
dpt头类型,支持天空检测。Metric-Large 输出原始米级深度。
社区资源
- Depth Anything 3 GitHub (ByteDance-Seed): 研究论文和代码
- Comfy-Org/Depth-Anything-3: 官方 ComfyUI 模型权重